Antes de que los investigadores de la Universidad de Washington pudieran hackear una computadora con ADN, tuvieron que conseguir que alguien fabricara su malware. Enviaron una secuencia a un servicio comercial de síntesis de ADN. El proveedor no pudo fabricarla. Una secuencia que funcionaba como código de computadora no cumplía los requisitos para convertirse en una molécula.[3]
En 2017, investigadores codificaron instrucciones informáticas maliciosas en ADN sintético y usaron los datos secuenciados para tomar el control de una computadora. La demostración funcionó en software que habían hecho deliberadamente vulnerable, no en un sistema ordinario de un laboratorio desprevenido.[1][2]
Peter Ney, Karl Koscher, Lee Organick, Luis Ceze y Tadayoshi Kohno habían aportado dos tipos de experiencia al mismo experimento: seguridad informática y manipulación de ADN. Querían seguir un posible ataque desde una muestra física hasta la máquina que procesa sus datos. ¿Podría algo que llega en un tubo de ensayo eventualmente decirle a esa computadora qué hacer?[2][3]
En el servicio de síntesis, su primer intento chocó con los hábitos de las moléculas reales. La secuencia se repetía demasiado. Contenía largas series de la misma letra genética, y algunos tramos tenían muy pocas bases C y G. El ADN repetitivo puede plegarse en estructuras problemáticas; una orden que parece sensata como instrucción de computadora puede ser difícil de fabricar como una hebra.[3]
Los investigadores volvieron a su código y lo rediseñaron en torno a esas limitaciones. Su hebra de trabajo tenía 176 bases de largo. El servicio aceptó la secuencia revisada sin errores ni advertencias, y el artículo registró el precio de síntesis al por menor para un fragmento de ese tamaño: $89. Para esa parte del experimento, el equipo de seguridad necesitaba un fabricante, no otro programador.[3]
Una vez que el ADN estuvo listo, lo pasaron por una ronda de secuenciación junto con otros experimentos. La secuenciación tradujo sus moléculas a las letras familiares A, C, G y T. Luego, el equipo pasó los datos resultantes a un programa modificado de compresión de ADN. La computadora se conectó de nuevo a su servidor, dándoles control remoto. La muestra había entrado como material de laboratorio y había emergido como instrucciones que la computadora obedeció.[3]
Antes de esa ejecución, el equipo había insertado deliberadamente una debilidad en el programa y había deshabilitado las protecciones informáticas comunes. Estaban probando si un ataque podría sobrevivir al viaje a través de la síntesis y la secuenciación. Habían dispuesto condiciones inusualmente favorables para el último paso. Su resultado no estableció que una muestra ordinaria pudiera tomar el control de una computadora de laboratorio ordinaria.[2][3]
En un examen separado de 13 programas de procesamiento de ADN ampliamente utilizados, los investigadores encontraron malas prácticas de seguridad y demostraron tres vulnerabilidades de desbordamiento de búfer. Un laboratorio podría recibir muestras de clientes externos y luego pasar sus datos secuenciados a través de una sucesión de programas. El equipo quería que los programadores que manejaban esos archivos consideraran a la persona que podría haber preparado la muestra. El equipo instó a mejorar las salvaguardas, aunque afirmó que en ese momento no tenía conocimiento de ataques contra sistemas de secuenciación.[2][3]
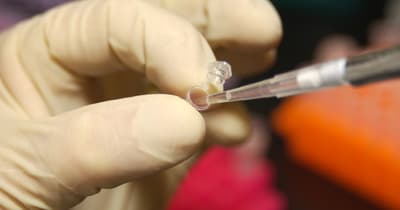
En el sitio web público del estudio, los investigadores respondieron a una pregunta que hacía que el experimento sonara como un tipo diferente de amenaza: ¿esto infectaría el genoma de alguien? No. La secuencia no tenía significado biológico.[2] En el artículo, una fotografía muestra lo que realmente habían hecho: un pequeño tubo de laboratorio que contenía su exploit sintetizado. Antes de que cualquier computadora pudiera manejarlo mal, alguien tenía que hacer el pedido correctamente.[3]