Antes que os pesquisadores da Universidade de Washington pudessem hackear um computador com DNA, eles tiveram que conseguir alguém para fabricar seu malware. Eles submeteram uma sequência a um serviço comercial de síntese de DNA. O fornecedor não conseguiu produzi-la. Uma sequência que funcionava como código de computador não atendeu aos requisitos para se tornar uma molécula.[3]
Em 2017, pesquisadores codificaram instruções de computador maliciosas em DNA sintético e usaram os dados sequenciados para assumir o controle de um computador. A demonstração funcionou em um software que eles haviam tornado deliberadamente vulnerável, e não em um sistema comum de um laboratório desavisado.[1][2]
Peter Ney, Karl Koscher, Lee Organick, Luis Ceze e Tadayoshi Kohno trouxeram dois tipos de especialização para o mesmo experimento: segurança de computador e manipulação de DNA. Eles queriam acompanhar um possível ataque desde uma amostra física até a máquina que processava seus dados. Algo chegando em um tubo de ensaio poderia eventualmente dizer ao computador o que fazer?[2][3]
No serviço de síntese, a primeira tentativa deles esbarrou nos hábitos das moléculas reais. A sequência se repetia demais. Ela continha longas sequências da mesma letra genética, e alguns trechos tinham muito poucas das bases C e G. O DNA repetitivo pode se dobrar em estruturas problemáticas; uma ordem que parece sensata como instruções de computador pode ser difícil de fabricar como uma fita.[3]
Os pesquisadores voltaram ao seu código e o redesenharam em torno dessas restrições. Sua fita de trabalho tinha 176 bases de comprimento. O serviço aceitou a sequência revisada sem erros ou avisos, e o artigo registrou o preço de varejo da síntese para um fragmento desse tamanho: $89. Para essa parte do experimento, a equipe de segurança precisava de um fabricante, não de outro programador.[3]
Assim que o DNA ficou pronto, eles o enviaram para uma rodada de sequenciamento junto com outros experimentos. O sequenciamento traduziu suas moléculas nas letras familiares A, C, G e T. A equipe então passou os dados resultantes para um programa modificado de compressão de DNA. O computador se conectou de volta ao servidor deles, dando-lhes controle remoto. A amostra entrou como material de laboratório e emergiu como instruções que o computador obedeceu.[3]
Antes dessa rodada, a equipe havia inserido deliberadamente uma fraqueza no programa e desativado as proteções comuns do computador. Eles estavam testando se um ataque poderia sobreviver à viagem através da síntese e do sequenciamento. Eles haviam arranjado condições excepcionalmente favoráveis para a última etapa. O resultado deles não estabeleceu que uma amostra comum poderia comandar um computador de laboratório comum.[2][3]
Em um exame separado de 13 programas amplamente utilizados para processamento de DNA, os pesquisadores encontraram práticas de segurança precárias e demonstraram três vulnerabilidades de estouro de buffer. Um laboratório pode receber amostras de clientes externos e, em seguida, passar seus dados sequenciados por uma sucessão de programas. A equipe queria que os programadores que lidavam com esses arquivos considerassem a pessoa que poderia ter preparado a amostra. A equipe instou a melhores salvaguardas, embora afirmasse não ter conhecimento de ataques contra sistemas de sequenciamento na época.[2][3]
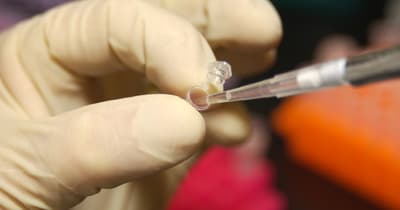
No site público do estudo, os pesquisadores responderam a uma pergunta que fazia o experimento parecer um tipo diferente de ameaça: isso infectaria o genoma de alguém? Não. A sequência não tinha significado biológico.[2] No artigo, uma fotografia mostra o que eles realmente fizeram: um pequeno tubo de laboratório contendo seu exploit sintetizado. Antes que qualquer computador pudesse lidar incorretamente com ele, alguém tinha que fazer o pedido certo.[3]