华盛顿大学的研究人员在使用DNA入侵计算机之前,必须先找到人来制造他们的恶意软件。他们向一家商业DNA合成服务机构提交了一个序列。然而,供应商未能成功制造。一个作为计算机代码的序列未能满足成为分子的要求。[3]
2017年,研究人员将恶意计算机指令编码到合成DNA中,并利用测序数据控制了一台计算机。这项演示是在他们故意制造漏洞的软件上进行的,而不是在不知情的实验室的普通系统上。[1][2]
Peter Ney、Karl Koscher、Lee Organick、Luis Ceze和Tadayoshi Kohno将计算机安全和DNA操作这两种专业知识带到了同一个实验中。他们希望追踪一次可能的攻击,从物理样本一直到处理其数据的机器。试管中的东西最终能否告诉计算机该做什么呢?[2][3]
在合成服务中,他们的第一次尝试遇到了实际分子的特性。该序列重复过多,包含了大量相同的遗传字母,并且有些区域的碱基C和G含量过低。重复的DNA会折叠成麻烦的结构;一个作为计算机指令看起来合理的序列,作为DNA链制造起来可能很困难。[3]
研究人员回到他们的代码,围绕这些限制重新设计。他们工作用的DNA链长176个碱基。该服务无错误或警告地接受了修改后的序列,并且论文记录了这种大小片段的零售合成价格:89美元。对于实验的这一部分,安全团队需要的是制造商,而不是另一位程序员。[3]
DNA准备好后,他们将其与其他实验一起进行测序。测序将其分子转化为熟悉的字母A、C、G和T。随后,团队将生成的数据传递给一个经过修改的DNA压缩程序。计算机连接回他们的服务器,使他们获得了远程控制权。样本作为实验室材料进入,最终以计算机服从的指令形式出现。[3]
在那次运行之前,团队故意在程序中插入了一个弱点,并禁用了常见的计算机保护措施。他们正在测试攻击能否在合成和测序过程中幸存下来。他们为最后一步创造了异常有利的条件。他们的结果并未证明普通样本可以控制普通的实验室计算机。[2][3]
在对13个广泛使用的DNA处理程序进行的单独检查中,研究人员发现了糟糕的安全实践,并展示了三个缓冲区溢出漏洞。实验室可能会接收来自外部客户的样本,然后将其测序数据通过一系列程序处理。该团队希望处理这些文件的程序员考虑可能准备样本的人。该团队敦促采取更好的安全措施,同时表示当时并未发现针对测序系统的攻击。[2][3]
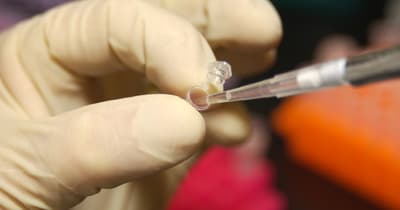
在该研究的公开网站上,研究人员回答了一个让实验听起来像另一种威胁的问题:这会感染任何人的基因组吗?不会。该序列没有生物学意义。[2]在论文中,一张照片展示了他们实际制造的东西:一个装有他们合成的“漏洞”的小实验室试管。在任何计算机错误处理它之前,必须有人正确地发出指令。[3]