Bevor die Forscher der University of Washington einen Computer mit DNA hacken konnten, mussten sie jemanden finden, der ihre Malware herstellte. Sie reichten eine Sequenz bei einem kommerziellen DNA-Synthesedienst ein. Der Anbieter konnte sie nicht herstellen. Eine Sequenz, die als Computercode funktionierte, erfüllte die Anforderungen an ein Molekül nicht.[3]
Im Jahr 2017 verschlüsselten Forscher bösartige Computeranweisungen in synthetischer DNA und nutzten die sequenzierten Daten, um einen Computer zu übernehmen. Die Demonstration funktionierte mit Software, die sie absichtlich anfällig gemacht hatten, nicht mit dem gewöhnlichen System eines ahnungslosen Labors.[1][2]
Peter Ney, Karl Koscher, Lee Organick, Luis Ceze und Tadayoshi Kohno hatten zwei Arten von Fachwissen in dasselbe Experiment eingebracht: Computersicherheit und DNA-Manipulation. Sie wollten einen möglichen Angriff von einer physischen Probe bis zur Maschine, die deren Daten verarbeitet, verfolgen. Könnte etwas, das in einem Reagenzglas ankommt, diesem Computer schließlich sagen, was er tun soll?[2][3]
Beim Synthesedienst stieß ihr erster Versuch auf die Gewohnheiten tatsächlicher Moleküle. Die Sequenz wiederholte sich zu oft. Sie enthielt lange Abschnitte desselben genetischen Buchstabens, und einige Abschnitte hatten zu wenig der Basen C und G. Repetitive DNA kann sich zu problematischen Strukturen falten; eine Anweisung, die als Computerbefehl sinnvoll erscheint, kann als Strang schwierig herzustellen sein.[3]
Die Forscher kehrten zu ihrem Code zurück und überarbeiteten ihn unter Berücksichtigung dieser Einschränkungen. Ihr Arbeitsstrang war 176 Basen lang. Der Dienst akzeptierte die überarbeitete Sequenz ohne Fehler oder Warnungen, und das Papier verzeichnete den Einzelhandelssynthesepreis für ein Fragment dieser Größe: 89 $. Für diesen Teil des Experiments benötigte das Sicherheitsteam einen Hersteller, keinen weiteren Programmierer.[3]
Als die DNA fertig war, schickten sie sie zusammen mit anderen Experimenten durch einen Sequenzierungslauf. Die Sequenzierung übersetzte ihre Moleküle in die bekannten Buchstaben A, C, G und T. Das Team gab die resultierenden Daten dann an ein modifiziertes DNA-Kompressionsprogramm weiter. Der Computer stellte eine Verbindung zu ihrem Server her und gab ihnen die Fernsteuerung. Die Probe war als Labormaterial eingegeben worden und als Anweisungen hervorgegangen, denen der Computer gehorchte.[3]
Vor diesem Lauf hatte das Team absichtlich eine Schwachstelle in das Programm eingefügt und gängige Computersicherheitsmaßnahmen deaktiviert. Sie testeten, ob ein Angriff den Weg durch Synthese und Sequenzierung überleben konnte. Für den letzten Schritt hatten sie ungewöhnlich günstige Bedingungen geschaffen. Ihr Ergebnis belegte nicht, dass eine gewöhnliche Probe einen gewöhnlichen Laborcomputer übernehmen könnte.[2][3]
In einer separaten Untersuchung von 13 weit verbreiteten DNA-Verarbeitungsprogrammen fanden die Forscher schlechte Sicherheitspraktiken und demonstrierten drei Pufferüberlauf-Schwachstellen. Ein Labor könnte Proben von externen Kunden erhalten und deren sequenzierte Daten dann durch eine Reihe von Programmen leiten. Das Team wollte, dass die Programmierer, die diese Dateien verarbeiten, die Person berücksichtigen, die die Probe vorbereitet haben könnte. Das Team forderte bessere Sicherheitsvorkehrungen, erklärte jedoch, dass ihm zu diesem Zeitpunkt keine Angriffe auf Sequenzierungssysteme bekannt seien.[2][3]
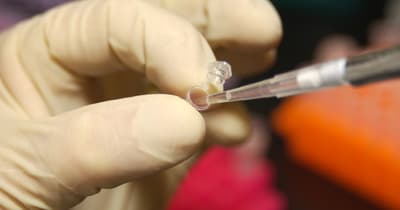
Auf der öffentlichen Website der Studie beantworteten die Forscher eine Frage, die das Experiment wie eine andere Art von Bedrohung klingen ließ: Würde dies das Genom von irgendjemandem infizieren? Nein. Die Sequenz hatte keine biologische Bedeutung.[2] Im Artikel zeigt ein Foto, was sie tatsächlich hergestellt hatten: ein kleines Laborröhrchen, das ihren synthetisierten Exploit enthielt. Bevor ein Computer ihn falsch verarbeiten konnte, musste jemand die Bestellung richtig aufgeben.[3]