Prima che i ricercatori dell'Università di Washington potessero hackerare un computer con il DNA, dovettero trovare qualcuno che producesse il loro malware. Sottoposero una sequenza a un servizio commerciale di sintesi del DNA. Il fornitore non riuscì a realizzarla. Una sequenza che funzionava come codice informatico non aveva soddisfatto i requisiti per diventare una molecola.[3]
Nel 2017, i ricercatori hanno codificato istruzioni informatiche dannose nel DNA sintetico e hanno utilizzato i dati sequenziati per prendere il controllo di un computer. La dimostrazione ha funzionato su software che avevano deliberatamente reso vulnerabile, non su un sistema ordinario di un laboratorio ignaro.[1][2]
Peter Ney, Karl Koscher, Lee Organick, Luis Ceze e Tadayoshi Kohno avevano portato due tipi di esperienza nello stesso esperimento: sicurezza informatica e manipolazione del DNA. Volevano seguire un possibile attacco dalla fase di un campione fisico fino alla macchina che elaborava i suoi dati. Poteva qualcosa che arrivava in una provetta alla fine dire a quel computer cosa fare?[2][3]
Al servizio di sintesi, il loro primo tentativo si scontrò con le abitudini delle molecole reali. La sequenza si ripeteva troppo. Conteneva lunghe sequenze della stessa lettera genetica, e alcuni tratti avevano troppo poche delle basi C e G. Il DNA ripetitivo può ripiegarsi in strutture problematiche; un ordine che appare sensato come istruzioni informatiche può essere difficile da produrre come filamento.[3]
I ricercatori tornarono al loro codice e lo riprogettarono tenendo conto di tali vincoli. Il loro filamento di lavoro era lungo 176 basi. Il servizio accettò la sequenza rivista senza errori o avvisi, e l'articolo registrò il prezzo al dettaglio per la sintesi di un frammento di quella dimensione: $89. Per quella parte dell'esperimento, il team di sicurezza aveva bisogno di un produttore, non di un altro programmatore.[3]
Una volta pronto il DNA, lo sottoposero a una sequenza di sequenziamento insieme ad altri esperimenti. Il sequenziamento tradusse le sue molecole nelle familiari lettere A, C, G e T. Il team passò quindi i dati risultanti a un programma di compressione del DNA modificato. Il computer si ricollegò al loro server, dando loro il controllo remoto. Il campione era entrato come materiale di laboratorio ed era emerso come istruzioni che il computer obbediva.[3]
Prima di quella esecuzione, il team aveva deliberatamente inserito una debolezza nel programma e disabilitato le comuni protezioni informatiche. Stavano testando se un attacco potesse sopravvivere al percorso attraverso la sintesi e il sequenziamento. Avevano predisposto condizioni insolitamente favorevoli per l'ultimo passaggio. Il loro risultato non stabiliva che un campione ordinario potesse assumere il controllo di un normale computer di laboratorio.[2][3]
In un esame separato di 13 programmi ampiamente utilizzati per l'elaborazione del DNA, i ricercatori hanno riscontrato scarse pratiche di sicurezza e hanno dimostrato tre vulnerabilità di buffer overflow. Un laboratorio potrebbe ricevere campioni da clienti esterni, quindi passare i loro dati sequenziati attraverso una successione di programmi. Il team voleva che i programmatori che gestivano quei file considerassero la persona che avrebbe potuto preparare il campione. Il team ha esortato a migliorare le misure di sicurezza, pur affermando di non essere a conoscenza di attacchi contro i sistemi di sequenziamento all'epoca.[2][3]
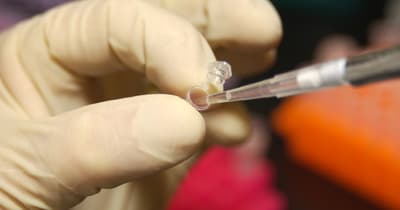
Sul sito web pubblico dello studio, i ricercatori hanno risposto a una domanda che faceva sembrare l'esperimento una minaccia di altro tipo: questo infetterebbe il genoma di qualcuno? No. La sequenza non aveva alcun significato biologico.[2] Nel documento, una fotografia mostra ciò che avevano effettivamente creato: una piccola provetta da laboratorio contenente il loro exploit sintetizzato. Prima che qualsiasi computer potesse gestirlo in modo improprio, qualcuno doveva ottenere l'ordine corretto.[3]