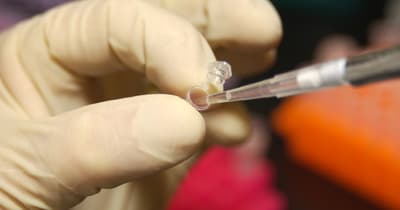
Avant que les chercheurs de l'Université de Washington ne puissent pirater un ordinateur avec de l'ADN, ils devaient trouver quelqu'un pour fabriquer leur logiciel malveillant. Ils ont soumis une séquence à un service commercial de synthèse d'ADN. Le fournisseur n'a pas pu la fabriquer. Une séquence qui fonctionnait comme du code informatique n'avait pas satisfait aux exigences pour devenir une molécule.[3]
En 2017, des chercheurs ont encodé des instructions informatiques malveillantes dans de l'ADN synthétique et ont utilisé les données séquencées pour prendre le contrôle d'un ordinateur. La démonstration a fonctionné sur un logiciel qu'ils avaient délibérément rendu vulnérable, et non sur le système ordinaire d'un laboratoire non averti.[1][2]
Peter Ney, Karl Koscher, Lee Organick, Luis Ceze et Tadayoshi Kohno avaient apporté deux types d'expertise à la même expérience : la sécurité informatique et la manipulation de l'ADN. Ils voulaient suivre une attaque possible depuis un échantillon physique jusqu'à la machine traitant ses données. Quelque chose arrivant dans un tube à essai pourrait-il finalement dire à cet ordinateur quoi faire ?[2][3]
Au service de synthèse, leur première tentative s'est heurtée aux habitudes des molécules réelles. La séquence se répétait trop. Elle contenait de longues séries de la même lettre génétique, et certains tronçons contenaient trop peu des bases C et G. L'ADN répétitif peut se replier en structures problématiques ; une commande qui semble sensée comme instruction informatique peut être difficile à fabriquer sous forme de brin.[3]
Les chercheurs sont revenus à leur code et l'ont repensé autour de ces contraintes. Leur brin fonctionnel mesurait 176 bases de long. Le service a accepté la séquence révisée sans erreurs ni avertissements, et l'article a enregistré le prix de détail de synthèse pour un fragment de cette taille : 89 $. Pour cette partie de l'expérience, l'équipe de sécurité avait besoin d'un fabricant, pas d'un autre programmeur.[3]
Une fois l'ADN prêt, ils l'ont soumis à un séquençage aux côtés d'autres expériences. Le séquençage a traduit ses molécules en lettres familières A, C, G et T. L'équipe a ensuite transmis les données résultantes à un programme de compression d'ADN modifié. L'ordinateur s'est reconnecté à leur serveur, leur donnant le contrôle à distance. L'échantillon était entré comme matériel de laboratoire et en est ressorti sous forme d'instructions que l'ordinateur a obéies.[3]
Avant cette exécution, l'équipe avait délibérément inséré une faiblesse dans le programme et désactivé les protections informatiques courantes. Ils testaient si une attaque pouvait survivre au voyage à travers la synthèse et le séquençage. Ils avaient organisé des conditions inhabituellement favorables pour la dernière étape. Leur résultat n'a pas établi qu'un échantillon ordinaire pouvait prendre le contrôle d'un ordinateur de laboratoire ordinaire.[2][3]
Dans un examen séparé de 13 programmes de traitement d'ADN largement utilisés, les chercheurs ont constaté de mauvaises pratiques de sécurité et ont démontré trois vulnérabilités de dépassement de tampon. Un laboratoire pourrait recevoir des échantillons de clients externes, puis faire passer leurs données séquencées à travers une succession de programmes. L'équipe voulait que les programmeurs manipulant ces fichiers prennent en compte la personne qui aurait pu préparer l'échantillon. L'équipe a exhorté à de meilleures protections tout en affirmant n'avoir connaissance d'aucune attaque contre les systèmes de séquençage à l'époque.[2][3]
Sur le site web public de l'étude, les chercheurs ont répondu à une question qui faisait ressembler l'expérience à un type de menace différent : cela infecterait-il le génome de quelqu'un ? Non. La séquence n'avait aucune signification biologique.[2] Dans l'article, une photographie montre ce qu'ils avaient réellement fabriqué : un petit tube de laboratoire contenant leur exploit synthétisé. Avant qu'un ordinateur ne puisse le mal gérer, quelqu'un devait passer la commande correctement.[3]