Voordat de onderzoekers van de Universiteit van Washington een computer konden hacken met DNA, moesten ze iemand vinden die hun malware kon produceren. Ze dienden een sequentie in bij een commerciële DNA-synthesedienst. De leverancier kon het niet maken. Een sequentie die als computercode werkte, voldeed niet aan de eisen om een molecuul te worden.[3]
In 2017 codeerden onderzoekers kwaadaardige computerinstructies in synthetisch DNA en gebruikten de gesequenceerde gegevens om een computer over te nemen. De demonstratie werkte op software die ze opzettelijk kwetsbaar hadden gemaakt, niet op een gewoon systeem van een nietsvermoedend laboratorium.[1][2]
Peter Ney, Karl Koscher, Lee Organick, Luis Ceze en Tadayoshi Kohno hadden twee soorten expertise samengebracht in hetzelfde experiment: computerbeveiliging en DNA-manipulatie. Ze wilden een mogelijke aanval helemaal volgen, van een fysiek monster tot de machine die de gegevens verwerkte. Zou iets dat in een reageerbuis aankwam de computer uiteindelijk kunnen vertellen wat te doen?[2][3]
Bij de synthesedienst stuitten hun eerste pogingen op de eigenschappen van echte moleculen. De sequentie herhaalde zichzelf te veel. Het bevatte lange reeksen van dezelfde genetische letter, en sommige stukken hadden te weinig van de basen C en G. Repetitief DNA kan zich vouwen tot problematische structuren; een volgorde die als computerinstructie logisch lijkt, kan moeilijk te produceren zijn als een streng.[3]
De onderzoekers keerden terug naar hun code en herontwierpen deze rondom die beperkingen. Hun werkende streng was 176 basen lang. De dienst accepteerde de herziene sequentie zonder fouten of waarschuwingen, en het artikel vermeldde de verkoopprijs voor de synthese van een fragment van die grootte: $89. Voor dat deel van het experiment had het beveiligingsteam een fabrikant nodig, geen andere programmeur.[3]
Zodra het DNA klaar was, lieten ze het sequencen naast andere experimenten. Sequencing vertaalde de moleculen naar de bekende letters A, C, G en T. Het team gaf de resulterende gegevens vervolgens door aan een aangepast DNA-compressieprogramma. De computer maakte opnieuw verbinding met hun server, waardoor ze afstandsbediening kregen. Het monster was binnengekomen als laboratoriummateriaal en kwam tevoorschijn als instructies die de computer gehoorzaamde.[3]
Voor die run had het team opzettelijk een zwakte in het programma ingebouwd en gangbare computerbeveiligingen uitgeschakeld. Ze testten of een aanval de reis door synthese en sequencing kon overleven. Ze hadden ongewoon gunstige omstandigheden geregeld voor de laatste stap. Hun resultaat bewees niet dat een gewoon monster een gewone laboratoriumcomputer kon overnemen.[2][3]
Bij een afzonderlijk onderzoek van 13 veelgebruikte DNA-verwerkingsprogramma's vonden de onderzoekers slechte beveiligingspraktijken en demonstreerden ze drie buffer-overflow kwetsbaarheden. Een laboratorium zou monsters van externe klanten kunnen ontvangen en vervolgens hun gesequenceerde gegevens door een reeks programma's kunnen laten gaan. Het team wilde dat de programmeurs die deze bestanden verwerkten, rekening hielden met de persoon die het monster mogelijk had voorbereid. Het team drong aan op betere beveiligingsmaatregelen, hoewel het op dat moment geen aanvallen op sequencing-systemen kende.[2][3]
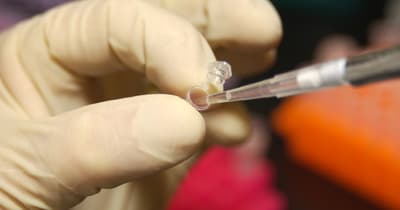
Op de openbare website van de studie beantwoordden de onderzoekers een vraag die het experiment deed klinken als een ander soort bedreiging: zou dit iemands genoom infecteren? Nee. De sequentie had geen biologische betekenis.[2] In het artikel toont een foto wat ze werkelijk hadden gemaakt: een kleine laboratoriumbuis met hun gesynthetiseerde exploit. Voordat een computer het verkeerd kon verwerken, moest iemand de bestelling correct uitvoeren.[3]